4일차의 주제는 EC2, ELB, Auto Scaling이다. 세 서비스를 한데 묶은 이유가 있다. 온프레미스에서 웹 서비스를 이중화할 때도 서버를 여러 대 두고, 앞단에 로드밸런서를 두고, 장애가 나거나 부하가 늘면 서버를 교체하거나 추가한다. AWS에서는 이 세 가지 역할을 각각 EC2, ELB, Auto Scaling이 맡는다.
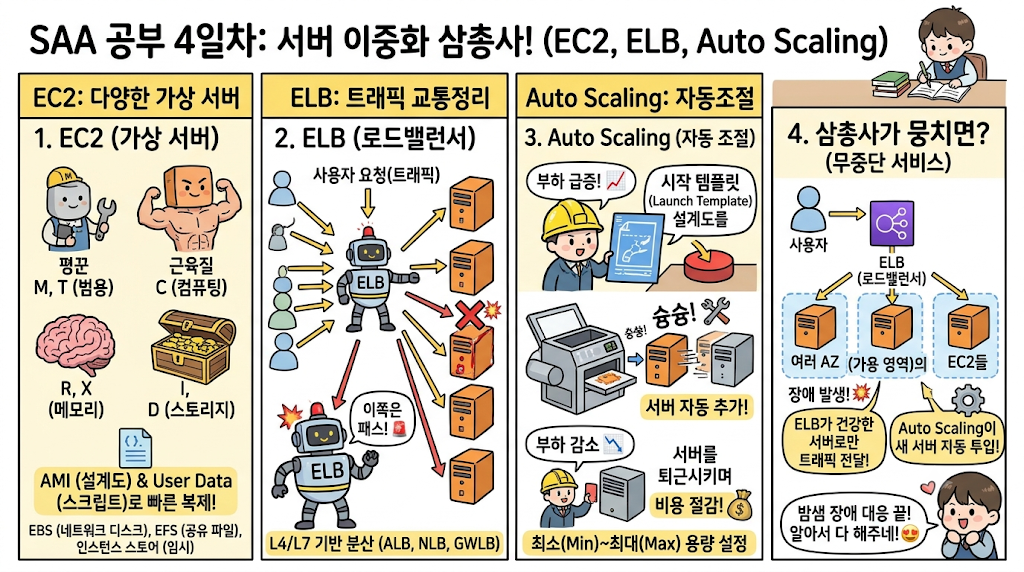
EC2는 여러 모양의 가상 서버였다
EC2(Elastic Compute Cloud)는 AWS의 가상 서버다. 온프레미스에서 하이퍼바이저 위에 VM을 만들던 것과 비슷하지만, SAA에서는 “VM을 만든다”보다 요구사항에 맞는 유형·구매 방식·스토리지를 고르는 것이 핵심이었다.
인스턴스 유형은 용도별로 나뉜다
인스턴스 이름은 m7i.large처럼 생겼다. 앞의 알파벳이 용도(패밀리), 숫자가 세대, 뒤는 추가 속성과 크기다. 시험에서는 세부 사양보다 패밀리의 방향을 아는 것이 중요했다.
| 분류 | 대표 패밀리 | 어울리는 워크로드 |
|---|---|---|
| 범용 | M, T | 웹 서버, 개발 환경. T는 평소에는 낮게 쓰다 가끔 몰리는 부하 |
| 컴퓨팅 최적화 | C | 인코딩, 배치 계산처럼 CPU를 많이 쓰는 작업 |
| 메모리 최적화 | R, X | 인메모리 캐시, 큰 데이터베이스 |
| 스토리지 최적화 | I, D | 로컬 디스크의 높은 I/O가 필요한 작업 |
| 가속 컴퓨팅 | P, G | GPU가 필요한 머신러닝, 그래픽 처리 |
AMI와 User Data
AMI(Amazon Machine Image)는 OS와 설치된 소프트웨어를 담은 서버 이미지다. 온프레미스에서 VM 템플릿이나 골든 이미지를 만들어 두고 서버를 복제하던 것과 같은 개념이다.
User Data는 인스턴스가 처음 시작될 때 실행할 스크립트다. 웹 서버 패키지 설치나 설정 파일 내려받기를 맡길 수 있다. 뒤에서 볼 Auto Scaling은 사람의 손을 거치지 않고 서버를 늘리기 때문에, AMI와 User Data로 새 서버가 알아서 준비되도록 만들어 두는 것이 중요하다고 느꼈다.
구매 옵션은 “얼마나 오래, 얼마나 안정적으로 쓰는가”의 문제
온프레미스에서는 서버를 사면 감가상각 기간 동안 쓰는 것이 당연했다. AWS에서는 같은 인스턴스도 어떻게 사느냐에 따라 비용이 크게 달라진다.
| 옵션 | 특징 | 시험에서 어울리는 상황 |
|---|---|---|
| On-Demand | 약정 없이 쓴 만큼 지불 | 예측하기 어렵거나 짧게 쓰는 워크로드 |
| Savings Plans | 1년 또는 3년 동안 시간당 사용 금액을 약정하고 할인 | 꾸준히 쓰지만 인스턴스 종류는 바뀔 수 있는 경우 |
| Reserved Instances | 1년 또는 3년 동안 특정 인스턴스 조건을 약정하고 할인 | 24시간 상시 운영되는 서버나 DB |
| Spot | AWS의 남는 용량을 크게 할인받아 씁. AWS가 필요하면 2분 전 알림 후 회수 | 중단돼도 다시 실행하면 되는 배치·분석 작업 |
| Dedicated Hosts | 물리 서버 한 대를 통째로 사용 | 소켓·코어 단위 라이선스나 규제 때문에 물리 서버를 구분해야 할 때 |
| Capacity Reservations | 특정 AZ에 용량을 미리 확보 | 할인보다 “필요할 때 반드시 띄울 수 있어야 하는” 경우 |
문제에서 “중단되어도 괜찮다”가 보이면 Spot, “1년 이상 꾸준히”가 보이면 Savings Plans나 Reserved Instances, “라이선스”가 보이면 Dedicated Hosts를 먼저 떠올리기로 했다.
스토리지: EBS, 인스턴스 스토어, EFS
이 부분은 집에서 쓰는 NAS와 연결하니 이해가 쉬웠다.
| 구분 | 온프레미스로 치면 | 특징 |
|---|---|---|
| EBS | SAN에서 할당한 디스크(LUN) | 네트워크로 붙는 블록 스토리지. 인스턴스를 중지해도 데이터가 남고, 스냅샷으로 백업한다. 같은 AZ의 인스턴스에만 붙일 수 있다 |
| 인스턴스 스토어 | 서버에 꽂힌 로컬 디스크 | 호스트에 붙어 있어 빠르지만, 인스턴스를 중지하거나 종료하면 데이터가 사라진다. 캐시나 임시 데이터용 |
| EFS | NAS의 NFS 공유 폴더 | 여러 인스턴스가 동시에 마운트하는 공유 파일 시스템. 여러 AZ에서 접근할 수 있다 |
SAA 문제에서 “여러 EC2가 같은 파일을 공유”는 EFS, “인스턴스를 꺼도 데이터 유지”는 EBS, “가장 빠른 임시 디스크”는 인스턴스 스토어로 구분하면 된다. 특히 EBS가 AZ에 묶여 있다는 점은 다중 AZ 설계 문제에서 함정으로 자주 쓰일 것 같다.
ELB는 클라우드의 L4·L7 스위치였다
온프레미스에서 웹 서버를 이중화할 때는 서버 앞에 L4 스위치나 로드밸런서 장비를 두고, 가상 IP로 들어온 요청을 여러 서버에 나눠 보낸다. 장비는 주기적으로 서버 상태를 확인해서 죽은 서버로는 요청을 보내지 않는다. ELB(Elastic Load Balancing)는 이 역할을 AWS가 관리형 서비스로 제공하는 것이다. 장비 이중화나 펌웨어 관리를 직접 하지 않아도 된다는 점이 가장 크게 다르다.
ELB의 종류
| 종류 | 동작 계층 | 특징 | 문제에서 보이는 단서 |
|---|---|---|---|
| ALB (Application) | L7 | HTTP·HTTPS 요청의 경로나 호스트 이름을 보고 대상을 나눔 | /api는 API 서버로, /images는 이미지 서버로 — 경로 기반 라우팅 |
| NLB (Network) | L4 | TCP·UDP·TLS 트래픽을 매우 낮은 지연으로 처리. AZ별로 고정 IP를 가질 수 있음 | 고정 IP, 초고성능, HTTP가 아닌 프로토콜 |
| GWLB (Gateway) | L3 | 방화벽·IDS 같은 가상 보안 어플라이언스로 트래픽을 보냄 | 서드파티 보안 장비를 통과시켜야 함 |
| CLB (Classic) | L4·L7 | 이전 세대 | 새로 설계할 때는 고르지 않는다 |
온프레미스 기준으로 보면 ALB는 L7 스위치의 URL 기반 분산, NLB는 L4 스위치의 포트 기반 분산, GWLB는 방화벽을 인라인으로 끼워 넣는 구성과 비슷했다.
리스너, 대상 그룹, 헬스 체크
ELB는 세 가지로 구성된다.
- 리스너: 어떤 포트와 프로토콜로 요청을 받을지 (예: HTTPS 443)
- 대상 그룹: 요청을 넘겨받을 EC2나 IP의 묶음
- 헬스 체크: 대상에 주기적으로 요청을 보내 살아 있는지 확인하고, 비정상인 대상에는 트래픽을 보내지 않음
헬스 체크 이야기를 보며 집 NAS에서 쓰는 Uptime Kuma가 떠올랐다. 다른 점은 Uptime Kuma는 상태를 알려 주기만 하고, ELB는 그 결과로 트래픽을 실제로 빼 준다는 것이다.
다중 AZ가 기본이다
ELB는 여러 AZ의 서브넷에 동시에 배치하고, 대상 EC2도 여러 AZ에 나눠 둔다. 그러면 AZ 하나에 장애가 나도 다른 AZ의 서버가 요청을 받는다. 1일차에 배운 “Subnet은 AZ 하나에만 속한다”는 내용이 여기서 이어진다. 고가용성을 원하면 여러 AZ에 서브넷을 만들고 각각에 서버를 두어야 한다.
교차 영역 로드 밸런싱(Cross-zone)도 구분해 두기로 했다. 켜면 AZ마다 서버 수가 달라도 전체 대상에 고르게 분산된다. ALB는 기본으로 켜져 있고, NLB는 기본으로 꺼져 있다.
Auto Scaling은 서버 증설과 교체를 자동으로 해 주었다
온프레미스에서 서버를 늘리려면 장비를 구매하고, 랙에 설치하고, OS를 올리고, 로드밸런서에 등록해야 한다. 며칠에서 몇 주가 걸리는 일이다. Auto Scaling은 이 과정을 몇 분 단위로, 그리고 자동으로 해 준다. 부하가 줄면 서버를 다시 줄여서 비용도 아낀다.
Auto Scaling 그룹의 구성 요소
- 시작 템플릿(Launch Template): 새 서버를 어떻게 만들지 정한 설계도다. AMI, 인스턴스 유형, 보안 그룹, User Data, 그리고 3일차에 배운 IAM Role까지 여기에 들어간다.
- 용량: 최소(Min), 원하는 용량(Desired), 최대(Max). 예를 들어 최소 2, 최대 6으로 두면 서버는 2대 아래로 줄지 않고 6대를 넘지 않는다.
- 서브넷: 여러 AZ의 서브넷을 지정하면 서버를 AZ에 나눠 배치한다.
- 헬스 체크: 기본은 EC2 상태 확인이다. ELB 헬스 체크를 함께 쓰도록 설정하면, 서버는 켜져 있지만 웹 서비스가 응답하지 않는 인스턴스도 비정상으로 보고 새 인스턴스로 교체한다.
조정 정책
| 정책 | 동작 | 어울리는 상황 |
|---|---|---|
| 대상 추적 (Target tracking) | “평균 CPU 50%”처럼 목표값을 정하면 그 값을 유지하도록 자동 조절 | 가장 간단하고 일반적인 선택 |
| 단계 (Step) | 지표가 얼마나 초과했는지에 따라 늘리는 대수를 다르게 | 부하 정도에 따라 단계적으로 대응해야 할 때 |
| 예약 (Scheduled) | 정해진 시간에 용량을 바꿈 | 매일 오전 9시 출근 시간처럼 부하 시간이 정해져 있을 때 |
| 예측 (Predictive) | 과거 패턴을 학습해 미리 늘림 | 주기적인 패턴이 뚜렷할 때 |
세 서비스가 함께 동작하는 구조
사용자
  |
  v
ALB (AZ-a, AZ-c 서브넷에 배치)
  |  헬스 체크를 통과한 대상으로만 전달
  v
대상 그룹
  |-- EC2 (AZ-a)
  |-- EC2 (AZ-c)
  ^
  |  시작 템플릿으로 서버를 만들고 대상 그룹에 자동 등록
Auto Scaling 그룹 (최소 2 / 최대 6)
  ^
  |  CloudWatch 지표(CPU 등)를 보고 조정
Auto Scaling 정책
이 구조에서 AZ-a에 장애가 나면, ALB는 AZ-c의 서버로만 트래픽을 보내고, Auto Scaling은 최소 용량을 맞추기 위해 살아 있는 AZ에 새 서버를 만든다. 온프레미스에서 사람이 밤새 하던 장애 대응의 상당 부분을 설계 단계에서 미리 정해 두는 셈이다.
다만 이 구조가 제대로 동작하려면 서버가 상태를 자기 디스크에만 들고 있으면 안 된다는 것도 깨달았다. 언제든 사라지고 새로 생길 수 있기 때문에, 업로드 파일은 S3나 EFS에, 세션과 데이터는 별도의 데이터베이스에 두는 설계가 필요하다. 집 NAS에서 Docker 컨테이너를 업데이트할 때 데이터를 볼륨으로 빼 두는 것과 같은 원리다.
4일차 공부를 마치며
오늘은 온프레미스에서 가장 익숙한 주제인 ‘서버 이중화’를 AWS 방식으로 다시 본 날이었다. 서버를 여러 대 두고, 앞에서 나눠 주고, 죽은 서버를 빼는 원리는 같았다. 다른 점은 그 일을 사람과 장비가 아니라 설정이 대신한다는 것이다. 그래서 AWS에서는 서버 한 대를 잘 만드는 것보다, 언제든 같은 서버를 다시 만들 수 있게 설계하는 것이 더 중요했다.
오늘 공부한 내용을 정리하면 다음과 같다.
- EC2 인스턴스 유형은 범용, 컴퓨팅, 메모리, 스토리지, 가속 컴퓨팅으로 나뉜다.
- AMI는 서버 이미지, User Data는 처음 시작할 때 실행하는 스크립트다.
- 중단되어도 되는 작업은 Spot, 꾸준한 워크로드는 Savings Plans나 Reserved Instances를 고려한다.
- EBS는 AZ에 묶인 블록 스토리지, 인스턴스 스토어는 임시 디스크, EFS는 여러 인스턴스가 함께 쓰는 파일 시스템이다.
- ALB는 L7 경로·호스트 기반, NLB는 L4 고성능·고정 IP, GWLB는 보안 어플라이언스 연결이다.
- Auto Scaling은 시작 템플릿과 최소·최대 용량, 조정 정책으로 서버를 늘리고 줄이고 교체한다.
다음 5일차에는 S3를 공부할 예정이다. 오늘 “서버가 사라져도 데이터는 남아야 한다”는 설계 원칙을 배웠으니, 그 데이터를 두는 대표적인 저장소인 S3의 스토리지 클래스와 수명 주기를 살펴볼 차례다.